dxy logo
首页丁香园病例库学术专区全部版块
搜索
登录
boardInfo
统计与作图
55.3 万讨论 · 77.2 万关注今日更新:5
本版版主
用户头像
遵循SPIRIT和CONSORT标准对随机对照试验中使用替代终点的扩展指南解读.pdf
随机对照试验正在越来越广泛地使用替代终点作为主要结局的评价指标,虽然其具有加快试验进程、减少样本量等诸多优势,但是,并非所有的替代终点都能很好的预测干预效果。因此,使用替代终点作为主要结局指标的规范性和后续验证问题受到人们的重视和思考。近期发布的《基于SPIRIT和CONSORT标准的替代终点扩展指南》对使用替代终点的随机对照试验制订了最低参照标准,旨在提高这些试验方案或报告的科学性及规范性。两个扩展指南的制订符合国际指南编写流程,这些条目在优化试验方案/报告质量的同时也有助于减少临床资源的浪费。本文将两个扩展指南一同对比解读,以期为广大研究者提供参考,引起相关从业者对替代终点及其背后诸多问题
255 浏览
生存分析规范实践——Kaplan-Meier曲线与Cox回归在肺癌患者预后评估中的应用
用户头像
金中乃鼎外科医师
【摘要】 生存分析是肿瘤预后研究的核心统计方法,其中Kaplan-Meier(KM)曲线可直观比较不同组间生存差异,Cox比例风险回归能量化独立预后因素,二者联合应用是《Journal of Clinical Oncology》《Lancet Oncology》等SCI期刊肿瘤方向的高频收录范式。本文以180例肺癌患者随访数据为例,系统阐述KM曲线的绘制与log-rank检验、Cox比例风险回归的规范实操,重点强调截尾数据编码、模型前提验证及SCI绘图与报告规范,为临床科研工作者提供可直接复用的预后分析方案,助力提升研究质量与投稿通过率。一、引言肺癌是全球发病率与死亡率最高的恶性肿瘤之一,不同
推荐 · 1673 浏览
求助!广义估计方程
用户头像
芝凹597护理学其他学科医学生
有没有大佬写sci用的广义估计方程啊,在论文结果部分应该放些什么数据呢,三线表又该怎么做才美观啊,求指导!
396 浏览 · 13 讨论
肿瘤真实世界研究的设计策略与分析技巧
随着精准医疗和大数据技术的发展,大量医疗数据不断积累,为真实世界研究(RWS)在肿瘤领域的应用提供了坚实支撑。真实世界数据源自临床实践,能够弥补随机对照试验的局限性,在肿瘤防控策略制定、药物研发和医保决策等方面中提供关键证据。文章系统总结了肿瘤RWS的设计策略,包括数据源选择、研究方向与研究设计类型,并深入探讨了数据分析技巧,如数据处理、统计分析方法及偏倚控制等内容。此外,文章还总结了当前肿瘤RWS所面临的挑战,如数据质量、隐私保护与异质性处理,以及人工智能驱动分析、全球协作等未来发展方向,为研究人员提供方法学参考,推动真实世界证据的规范化发展。
272 浏览
《药物流行病学研究方法学指南(第2版)》及其系列解读(12)_阴性对照方法的应用与案例解读.pdf
未测量偏倚是药物流行病学研究中的常见挑战,阴性对照可用来检测研究是否存在未测量偏倚,从而验证研究结果的可靠性。该研究基于《药物流行病学研究方法学指南(第2版)》,对阴性对照方法的应用及相关案例进行系统解读。首先,介绍阴性对照的定义与主要类型,包括阴性对照暴露、阴性对照时期和阴性对照结局,阐明其基本概念与适用情境。其次,阐述该方法的主要用途,即识别和校正未测量偏倚。然后,概述其实施步骤与统计分析方法,涵盖研究设计阶段的选择依据与统计分析阶段的偏倚检测策略。最后,通过对四类典型案例的详细解析,展示阴性对照在评估药物安全性、有效性的研究中识别和校正未测量混杂的实际应用价值。阴性对照虽不一定能完全消除
331 浏览
logistic 回归规范实践 —— 构建胃癌术后 1 年复发风险预测模型
用户头像
金中乃鼎外科医师
【摘要】胃癌术后复发是影响患者预后的核心难题,构建可靠的复发风险预测模型对制定个体化随访与干预策略具有重要临床价值。二分类 logistic 回归是构建二分类结局预测模型的经典方法,也是 SCI 期刊的热门收录方向,但临床科研中常存在「变量筛选不规范、模型验证缺失、结果报告不完整」等问题,导致研究结论可信度不足。本文以 200 例胃癌术后患者为研究对象,系统阐述二分类 logistic 回归的单因素分析、多因素筛选、模型拟合优度评价及 SCI 规范化报告流程,为临床科研工作者提供可直接复用的预测模型构建方案,同时探讨模型优化与外部验证的关键要点。一、引言胃癌是全球高发恶性肿瘤之一,手术切除是其
推荐 · 1336 浏览 · 3 讨论
laoss回归的横坐标总是表现为-log(λ),怎么回事,错了吗?
各位老师,我目前在做基于列线图的临床预测模型,laoss回归的横坐标总是表现为-log(λ),我试了试其他的数据,好像R语言的默认程序就是横坐标表现为-log(λ),但其他论文里都是以横坐标log(λ)呈现。怎么回事?最终写在论文里的图能以Laoss回归的横坐标表现为-log(λ)呈现吗?交叉验证的坐标轴一样,也是负值。
357 浏览
医学统计系列教程:相关分析的规范实践——Pearson与Spearman相关在糖尿病患者血糖血脂关联研究中的应用
用户头像
金中乃鼎外科医师
【摘要】 相关分析是探索变量间关联强度与方向的核心统计方法,Pearson相关与Spearman相关分别适用于不同数据分布特征的场景。临床科研中常存在“忽视数据分布特征盲目选择方法、混淆相关与因果、结果报告不规范”等问题,导致研究结论可信度不足。本文以120例2型糖尿病患者空腹血糖(FPG)与血脂指标(总胆固醇TC、低密度脂蛋白LDL-C等)的相关性分析为例,系统阐述Pearson与Spearman相关的适用场景、前提验证、规范操作流程(R与SPSS实操)、结果解读及SCI规范化报告要点,并总结常见误区与规避建议,为临床科研工作者提供可直接复用的统计分析方案。一、引言在2型糖尿病临床研究中,血
1553 浏览
求助!各位大佬meta分析数据提取时不同剂量应该怎么提取
用户头像
dxy_25q1aep5中药学医学生
本人在做一个网状meta研究,目的是比较不同种的药物疗效但是好几篇文献出现了一种药物的多种剂量对比研究,比如10 mg\20 mg\30mg和安慰剂的这个时候应怎么提取呢,不知道是该按照多臂研究全部提取呢还是选择一种剂量提取呢,找了好久也没找到合适的方法,有没有大佬能解答一下,感谢!
404 浏览 · 6 讨论
今日分享-实用现代统计分析方法与SPSS应用.pdf电子版
点击链接或复制整段内容,打开「夸克APP」即可获取。链接:https://pan.quark.cn/s/b47713f27736仅个人交流、不作商用
278 浏览
配对设计数据分析的规范实践——配对t检验与McNemar检验在哮喘疗效评价中的应用
用户头像
金中乃鼎外科医师
【摘要】 配对设计是临床科研中常用的实验设计类型,其核心优势在于控制个体变异,提高统计检验效能。配对t检验与McNemar检验分别适用于配对设计的计量资料与二分类计数资料组间比较,但实际应用中常因“混淆配对与独立设计、忽视适用条件、操作不规范”导致结论可信度不足。本文以50例哮喘患者治疗前后疗效评价为例,系统阐述配对t检验与McNemar检验的适用场景、规范操作流程(R与SPSS实操)、结果解读要点,并总结常见误区与规避建议,为临床科研工作者提供可直接复用的统计分析方案。一、引言在哮喘临床疗效评价中,自身前后对照设计(同一患者治疗前与治疗后指标对比)是常用研究模式,该设计通过控制个体基线差异(
969 浏览
计数资料组间比较的规范:卡方检验与Fisher精确检验在肺炎患者病原菌分布研究中的应用
用户头像
金中乃鼎外科医师
【摘要】 计数资料组间比较是临床科研的核心统计分析环节,卡方检验与Fisher精确检验是最常用的方法,但实际应用中常因“适用条件判断不清、操作不规范、结果解读片面”导致研究结论可信度不足。本文以儿童与成人肺炎患者病原菌分布比较为例,系统阐述2×2列联表卡方检验、多分类列联表卡方检验及Fisher精确检验的适用场景、规范操作流程(R与SPSS实操)、结果解读要点,并总结常见误区与规避建议,为临床科研工作者提供可直接复用的统计分析方案。一、引言在肺炎临床科研中,病原菌类型(细菌、病毒、混合感染)的组间分布差异分析,是制定针对性抗感染治疗策略的重要依据。计数资料的组间比较需严格匹配统计方法的适用条件
1276 浏览
基于回归/AI的预测模型质量、偏倚风险与适用性评价工具更新版:PROBAST+AI中文解读
基于人工智能(artificial intelligence,AI)和机器学习方法的临床预测模型开发和验证研究日益广泛,于2019年开发的预测模型偏倚风险和适用性评价工具(prediction model risk of bias assessment tool,PROBAST)-2019展现出明显的局限性。因此,2025年发布PROBAST-2019的扩展更新版本,即PROBAST+AI。该工具分为模型开发和模型评估部分,旨在全面、规范评价模型开发中潜在的方法学质量、模型评估中的偏倚风险及适用性。本文对PROBAST+AI工具进行系统性的条目解读和示例分析,以期为从事相关研究的科研人员提供指
945 浏览
计量资料组间比较的规范应用——基于肝癌患者肝功能指标的t检验与Wilcoxon秩和检验实
用户头像
此用户已注销注销用户
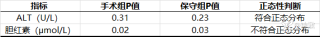
在肝癌临床科研中,肝功能指标(如谷丙转氨酶ALT、胆红素)的组间比较是评估治疗效果的核心环节。然而,临床研究者常因“忽视数据分布特征、盲目选择统计方法”导致结果可信度不足,甚至被期刊拒稿。本文以30例肝癌手术治疗组与28例保守治疗组患者的肝功能指标比较为例,系统梳理计量资料组间比较的规范流程(前提验证→方法选择→实操验证→结果表述),结合R与SPSS完整实操步骤,为临床科研人员提供可直接复用的方案,助力提升研究数据可靠性与论文投稿通过率。一、研究设计与数据特征(一)研究对象 纳入58例原发性肝癌患者,根据治疗方案分为两组:手术治疗组(n=30),男18例、女12例,平均年龄(56.8±8.2)
推荐 · 1546 浏览
JAMA论文解析倾向评分(Propensity Score Analysis, PSA)
用户头像
医研笔录免疫室医师
统计学临床研究指南:深入解析倾向评分(Propensity Score)——如何让观察性研究“接近”随机试验?在临床研究中,随机对照试验(Randomized Controlled Trial, RCT)被视为评估干预措施效果的“金标准”。然而,在现实世界中,由于伦理、可行性或成本等原因,许多重要的临床问题无法通过RCT来解答。此时,研究者往往需要依赖于观察性研究。观察性研究面临一个核心难题:治疗或暴露并非随机分配。这意味着接受某种治疗的患者与未接受该治疗的患者,在基线特征(如年龄、性别、疾病严重程度、合并症等)上可能存在系统性差异。这种差异,若同时与结局相关,就会导致混杂偏倚,使我们难以分辨
1259 浏览
真实世界研究:从金标准到临床实践
用户头像
医研笔录免疫室医师
在医学研究中,如何科学、准确地评估一种治疗方法的有效性,一直是科研人员和临床医生关注的焦点。传统上,随机对照试验(RCT) 被视为评价干预效果的“金标准”。然而,随着医学数据来源的多样化和研究需求的复杂化,真实世界研究(RWS) 正逐渐成为不可或缺的补充证据。本文将带你快速了解这两类研究的核心区别、联系,以及如何利用真实世界数据生成高质量的证据。第一部分:为什么随机对照试验是“金标准”?通过随机分配,研究人员可以最大程度地减少处理组和对照组之间的混杂因素,从而更可信地评估干预措施的效果。随机对照研究之所以被称为原始研究的金标准,是因为它具备以下四大优点: 01 随机分配消除选择偏倚随机分配可以
888 浏览 · 1 讨论
PRISMA+2020声明动态系统评价扩展版清单(PRISMA-LSR)解读.pdf
动态系统评价(living systematic review, LSR)是一种定期更新并纳入新证据的系统评价方法, 旨在快速反映最新研究成果。尽管LSR在临床领域日益普及, 但其报告质量参差不齐, 缺乏统一的报告规范。为提升LSR的报告质量, PRISMA 2020工作组发布了动态系统评价扩展版清单(PRISMA extension for living systematic review, PRISMA-LSR)。本文阐述PRISMA-LSR的发布背景及主要修订内容, 并结合实例进行解读, 旨在为未来LSR研究提供指导, 提升其报告质量。
769 浏览
统计描述怎么写?以冠心病患者为例,正确呈现均数 ± 标准差 / 中位数 + 四分位数
用户头像
此用户已注销注销用户
在临床研究投稿时,很多医生朋友会收到这样的审稿意见:“请补充计量资料的正态性检验结果,非正态分布指标不应使用均数 ± 标准差描述”“计数资料的百分比计算有误,建议重新核对”。其实,统计描述是 SCI 论文 “结果部分” 的开篇,也是审稿人最先关注的内容 —— 如果连 “年龄用均数还是中位数”“百分比怎么算” 都出错,后续再复杂的统计分析也会失去可信度。今天就以 180 例冠心病患者的真实数据为例,手把手教大家区分计量资料的描述方式,掌握计数资料的规范呈现,同时附上 R 和 SPSS 的实操步骤,让你的统计描述既符合临床逻辑,又满足 SCI 期刊要求。​先看一个常见的错误案例:某医生在论文中写道
推荐 · 2430 浏览
数据清洗实操:R+SPSS 处理糖尿病患者缺失值与异常值(附代码 / 步骤)
用户头像
此用户已注销注销用户
做临床统计时,很多医生朋友会陷入这样的困境:“收集了 200 例 2 型糖尿病患者的血糖、血脂数据,满心欢喜准备做分析,却发现数据里全是‘坑’——12 个空腹血糖值是空的,还有 8 个 BMI 低到 2.1 kg/m²,直接用这些数据做统计,结果肯定不可靠,更别说发 SCI 了。” 其实,数据清洗是医学统计的 “关键预处理环节”,就像做菜前要 “挑菜、洗菜”,只有把缺失值、异常值处理好,后续的 t 检验、回归分析才能得出可信结论。今天就以 200 例 2 型糖尿病患者的真实数据为例,手把手教大家用 R 和 SPSS 处理数据问题,每步都附具体代码和操作截图,看完就能上手。​先明确一个核心认知:
1042 浏览 · 2 讨论
变量编码避坑:以高血压患者数据为例,教你定义计量 / 计数 / 有序变量
用户头像
此用户已注销注销用户
今天分享医学统计系列第二篇文章,希望对你有帮助 做临床研究时,很多医生朋友会遇到这样的问题:“明明收集了完整的高血压患者数据,却因为变量定义混乱,后续统计分析频频出错,甚至被 SCI 期刊审稿人质疑数据可靠性。” 其实,变量编码是医学统计的 “第一步”,也是最容易踩坑的环节 —— 选对变量类型、做好编码,后续的统计描述、组间比较才能顺利推进。今天就以某医院 150 例高血压患者的真实数据为例,手把手教大家区分计量、计数、有序变量,掌握 SCI 期刊认可的编码规范。​先看一个真实场景:某医生收集了高血压患者的 “年龄、性别、收缩压、病程、疗效等级”5 类数据,直接用 Excel 录入后就开始做统
推荐 · 1481 浏览 · 1 讨论
【求助】如何拼接显微图片
用户头像
hhhhhhaaa临床医学其他学科医学生
请问请问,一系列重叠的HE显微图片,在用Fiji软件的stitching→Grid/Collection stitching功能(type用的Sequential Images)拼接成一张完整的HE组织切片图的时候,由于拍片时角度不正(但是再拍也还是这个角度),全部一起拼接的时候顺序不对,每一行分别拼接,出来都是类似这样阶梯状的,并且两行之间拼接不上,各位大佬有没有什么好的解决办法呀?
535 浏览 · 16 讨论
用浅显易懂的语言和生动的例子去轻松学会统计学
用户头像
王胤8916消化内科医师
统计学系列:1.临床科学研究的类型及区别联系
189 浏览
医学统计入门:为什么做肺癌临床研究,离不开统计?
用户头像
此用户已注销注销用户
作为临床医生,我们每天都在和患者打交道,也常面临这样的困惑:“我觉得A化疗方案治疗非小细胞肺癌效果更好,为什么还要做统计分析?”“凭多年临床经验就能判断疗效,统计是不是多此一举?”其实,在肺癌等临床研究中,统计不是“附加题”,而是确保研究结论可靠、能被SCI期刊认可的“必答题”。今天就用肺癌临床研究的真实场景,和大家聊聊医学统计的核心逻辑。先看一个真实案例:某科室收治了50例晚期非小细胞肺癌患者,25例用传统化疗方案(顺铂+培美曲塞),25例用新方案(化疗+免疫治疗)。治疗2个周期后,医生观察到新方案组有18例患者肿瘤缩小,传统方案组只有12例,直观感觉新方案更有效。但当把数据提交给SCI期刊
644 浏览 · 13 讨论
从论文设计到数据挖掘,一篇搞定生信统计分析全流程
用户头像
此用户已注销注销用户
大家好!作为常年在生信圈摸爬滚打的“老司机”,经常收到站友私信:“生信分析从哪开始?”“论文里的统计方法怎么选?”“R语言/Python到底哪个更实用?”今天就结合论文发表全流程,带大家系统梳理生信统计分析的核心要点,从方案设计到数据挖掘,再到分析工具和方法,新手也能快速上手!一、论文方案设计:从“讲故事”开始的统计逻辑生信分析不是“数据堆数据”,而是用数据验证科学假设。好的方案设计能帮你少走90%的弯路,核心步骤如下:1. 明确科学问题:3个灵魂拷问临床/基础价值:你的研究能否解决实际问题?(例:某基因在肺癌中的预后价值?某种突变是否影响免疫治疗响应?)创新点:别人做过吗?你能从新角度(数据
1931 浏览
Logistic 回归编码的深层陷阱与规避:基于肺癌诊断与预后研究案例
用户头像
此用户已注销注销用户
在肺癌诊断、预后及疗效评价等临床科研中,Logistic 回归是分析二分类结局关联的核心统计方法。然而,实际应用中,研究者常聚焦于 “因变量 Y=1 的编码是否与关注事件一致” 这一基础问题,却易忽视 “事件发生率对模型的影响”“多因素间编码协同性”“95% 置信区间(CI)的解读” 等深层陷阱,导致结论偏差甚至错误。本文结合肺癌相关研究案例,系统剖析 Logistic 回归编码的深层问题,提出针对性规避策略,为临床科研提供参考。​一、罕见事件下的模型选择陷阱:编码正确≠结论可靠​1. 案例背景与问题呈现​某研究分析 “肺癌术后并发症(因变量:0 = 未发生,1 = 发生)与手术时长(自变量:
648 浏览
肺癌诊断研究案例复盘:因变量编码反向致 CEA 结论矛盾,Logistic 回归如何纠偏?
用户头像
此用户已注销注销用户
在临床诊断类科研中,Logistic 回归是分析 “影响因素与二分类结局(如疾病阳性 / 阴性、诊断阳性 / 阴性)” 关联的核心方法。笔者近期开展 “某肿瘤标志物(CEA)与肺癌诊断价值” 研究时,因对 Logistic 回归因变量的编码逻辑理解偏差,导致 “CEA 与肺癌诊断的关联方向完全反转”,后续经统计专家指导修正后才恢复正确结论。结合此次经历,分享 Logistic 回归因变量编码的关键要点,供同行参考避坑。​一、问题核心:因变量编码错误为何会颠覆结论?​Logistic 回归分析二分类结局时,核心是通过 “优势比(OR 值)” 反映自变量对 “结局发生概率” 的影响 —— 而 OR
1198 浏览 · 19 讨论
肺癌疗效研究案例复盘:普通卡方检验误判疗效差异,秩和检验如何修正统计结论?
用户头像
此用户已注销注销用户
在临床科研中,有序分类资料(如疾病分期、疗效分级、疼痛评分等)的统计分析是高频场景,但笔者近期在肺癌疗效研究中,因误用普通 Pearson 卡方检验分析疾病分期(I/II/III 期),导致论文初审被拒,后续经导师指导修正方法后才顺利返修。结合此次经历,分享有序分类资料的正确统计方法,供同行参考避坑。一、问题核心:普通卡方检验为何不适用于有序资料?​普通 Pearson 卡方检验的核心是分析 “各组频数分布是否存在差异”,仅关注 “类别构成”,完全忽略了有序资料的 “等级顺序信息”(如 I 期<II 期<III 期的病情轻重递进关系、无效<有效<显效的疗效梯度差异)。这种 “信息浪费” 会导致
792 浏览 · 31 讨论
相关专题
医生必看典型病灶图
4933 帖子 · 668 人关注
职业生涯的难忘手术
927 帖子 · 2.6 万人关注
分享一例常见病例
2970 帖子 · 99 人关注
值班遇到的难忘病例
1306 帖子 · 128 人关注
门诊遇到的典型病例
593 帖子 · 119 人关注
分享有疑问的病例,帮你解疑
882 帖子 · 168 人关注
职业生涯的难忘病例
2320 帖子 · 229 人关注
缝合专场-分享你的美容缝合病例
2 帖子 · 16 人关注
一眼秒杀病例合集
397 帖子 · 443 人关注
分享一例棘手的病例
202 帖子 · 14 人关注
分享值班病例
434 帖子 · 25 人关注
分享 25 年度病例
108 帖子 · 17 人关注
分享新年病例
328 帖子 · 17 人关注
医生的「演技」修炼
28 帖子 · 9 人关注
处方点评打卡
9 帖子 · 8 人关注
主动脉夹层
26 帖子 · 33 人关注
流感病例
19 帖子 · 44 人关注
手法复位专场-分享你的复位病例
1 帖子 · 17 人关注
分享最近接诊的发热病例
18 帖子 · 8 人关注
分享一例不合理处方
11 帖子 · 14 人关注
分享一例意想不到的反转病例
15 帖子 · 6 人关注
分享做过时间最长的一次手术
6 帖子 · 8 人关注
分享一个病例汇报ppt
9 帖子 · 11 人关注
返回顶部