










【知识讲解】分子生物学常用网站介绍
在分子生物学研究中,常用的方法就是载体构建,即分别对目的基因和载体DNA用内切酶、连接酶等进行适当切割和修饰后,将二者连接在一起构建为质粒,再导入目的细胞,实现目的基因在目的细胞内的正确表达。
载体构建前期需要查找目的基因,以及对载体图谱进行分析,这时就需要用到一些分子生物网站软件,下面我们就来一一了解。
一、基因序列查询
NCBI和UniProt是我们序列来源的主要数据库,本文主要介绍这两个数据库:
NCBI(https://www.ncbi.nlm.nih.gov/)
和
Uniprot (https://www.uniprot.org/)
lNCBI
美国国家生物技术信息中心(NCBI)是美国国家医学图书馆的一部分,建立于1988年,主要从事分子生物学、生物化学、和遗传学的数据库和软件开发和研究。NCBI提供了GenBank、Entrez、BLAST等多种数据库和工具,以及人才培养和教育和训练的服务。
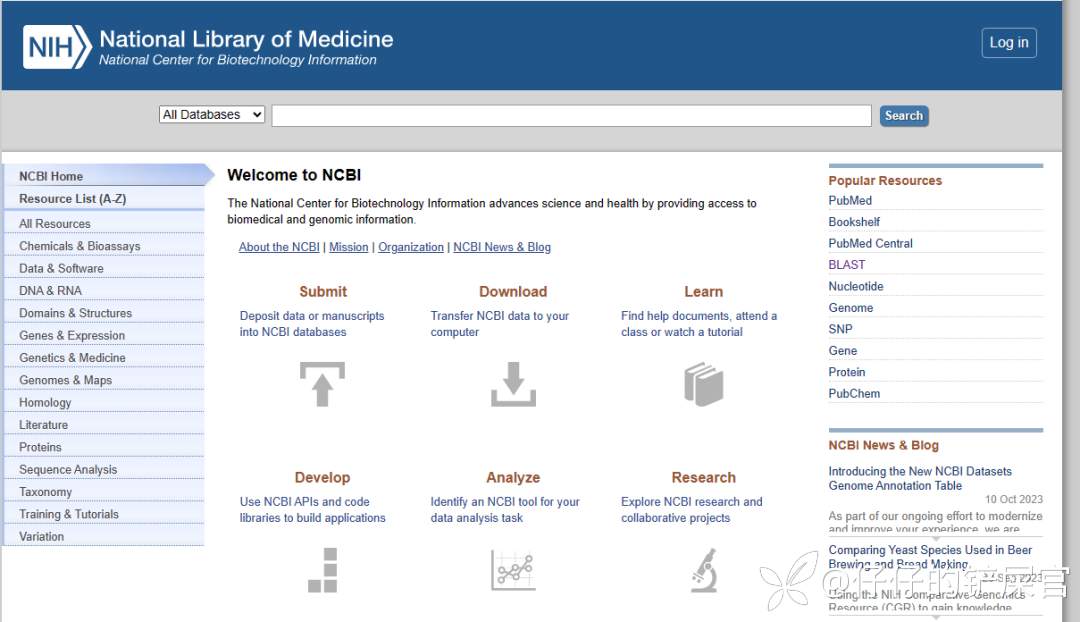
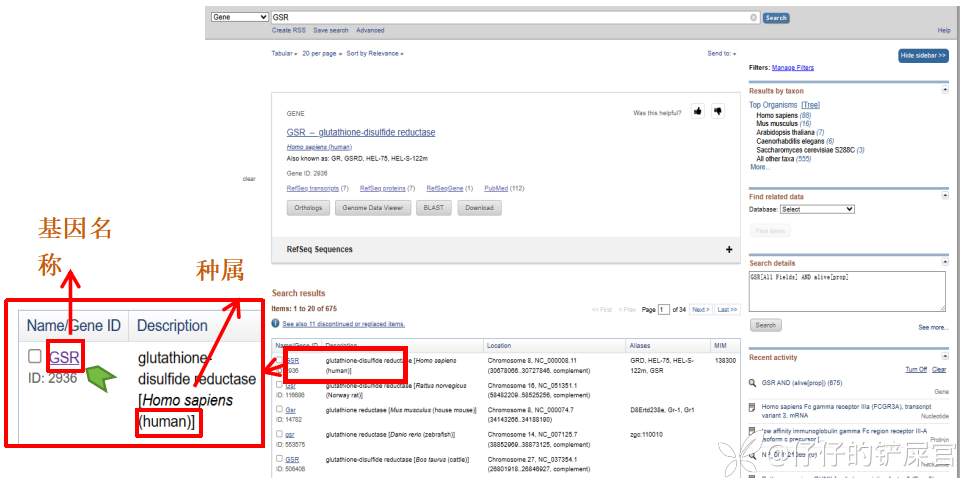
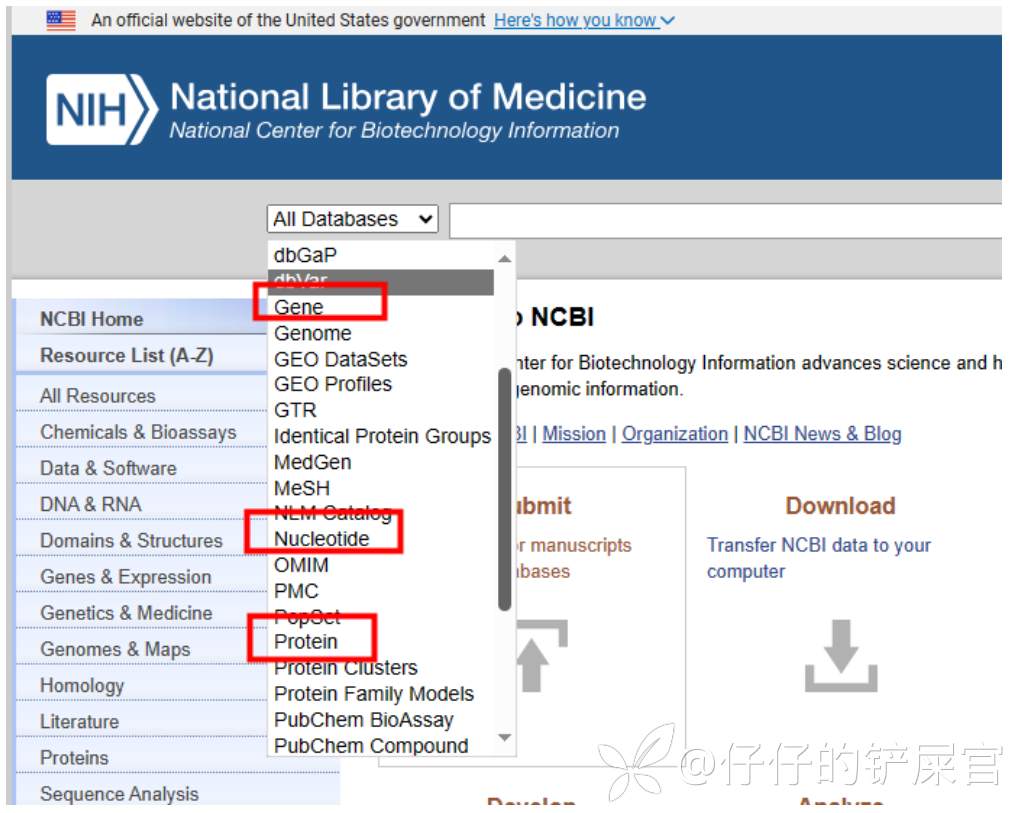
以人类GSR基因为例,在“All Databases”一栏选择“Gene”,输入基因名称,点击search查看结果,如图所示,然后点击对应的种属的基因名(绿色箭头指示位置)
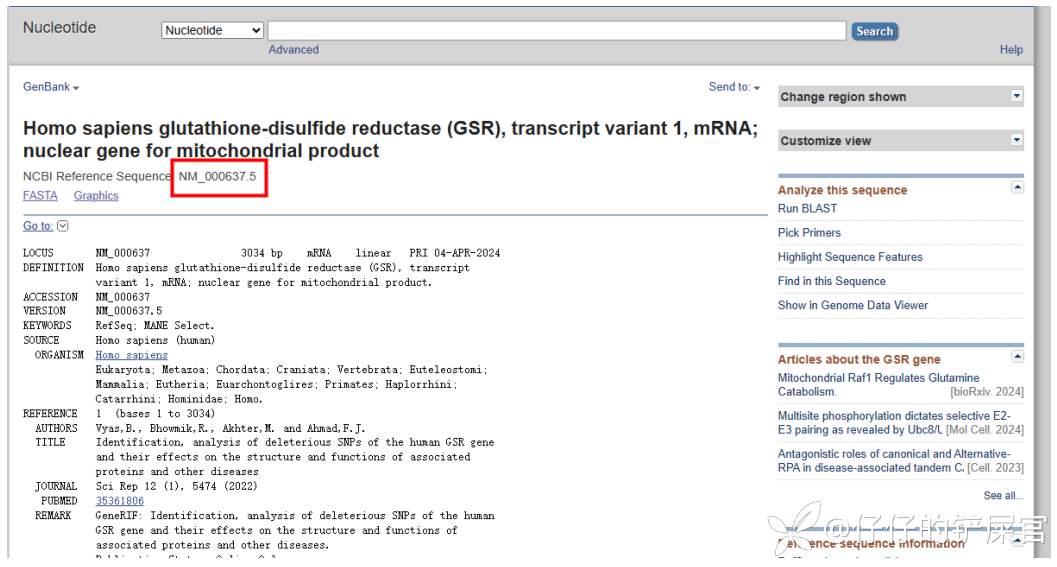
点击基因名称,跳转至详细基因页面,有nm编码、基因全称、种属、别名等。
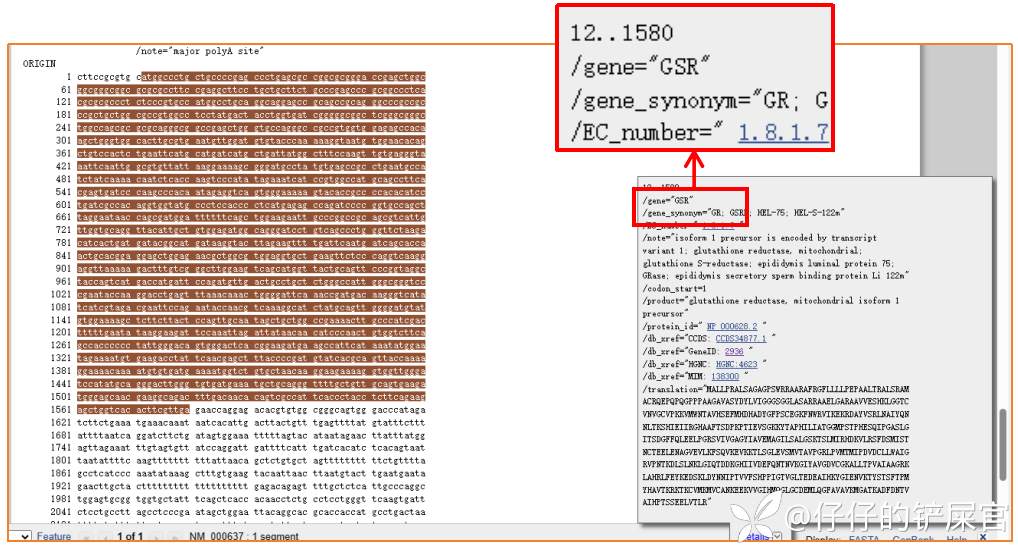
下拉至CDS区,有CDS区长度等信息,点击会跳转至序列信息。CDS区长度为后位数字减去前位数字加一,且一定是3的倍数。
此外,也可用nm编码、np编码等进行快速查询,“Gene”数据库适用于基因名称查询,“Nucleotide”适用于nm编码查询,“Protein”适用于np编码查询;以及可以用碱基/蛋白序列查询其基因名称,可用BLAST工具。
lUniprot
UniProt整合了Swiss-Prot、 TrEMBL 和 PIR-PSD 三个数据库,主要优势在于添加了蛋白功能注释信息。具有更新速度快、与其他数据库联系密切、分析工具齐全、使用便捷的特点,成为了目前信息最丰富、资源最广的蛋白质数据库。
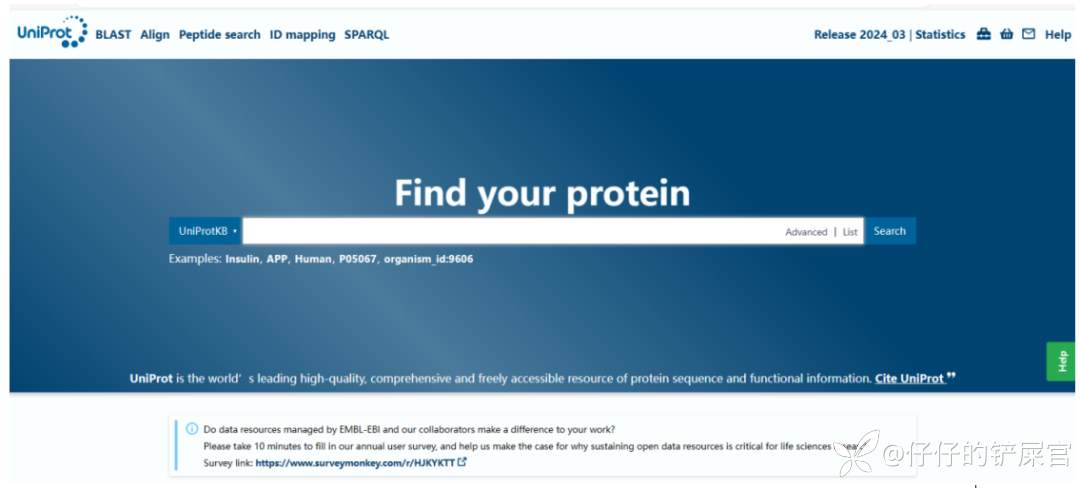
若已知UniProtID, 则可直接在 首页顶部 搜索栏进行搜索。点击“go to sequence” 可直达氨基酸序列。
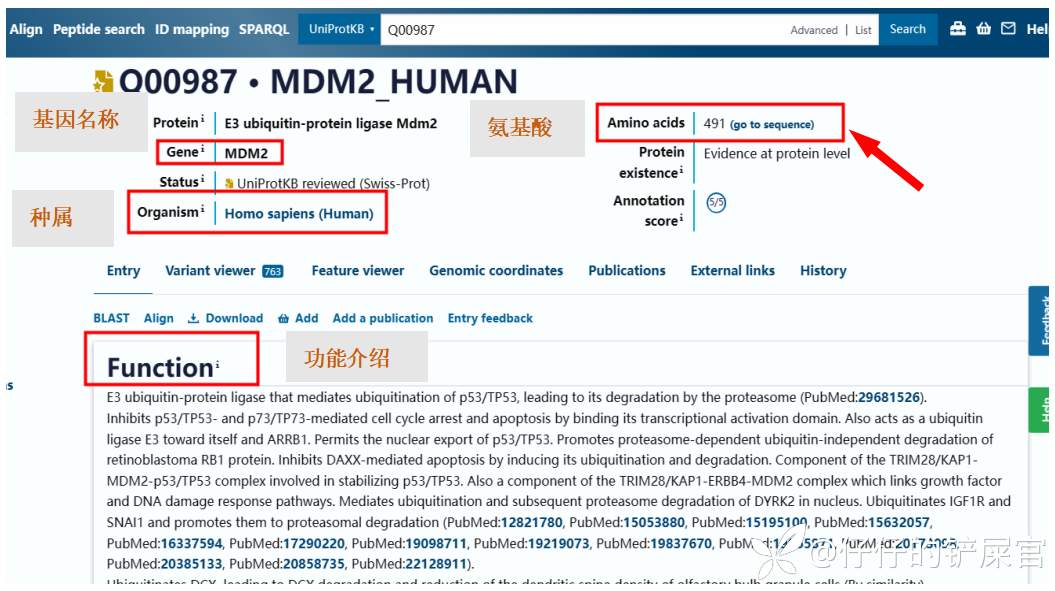
或者可以用基因名称进行搜索,用种属、蛋白长度等信息进行判断。
二、软件分析
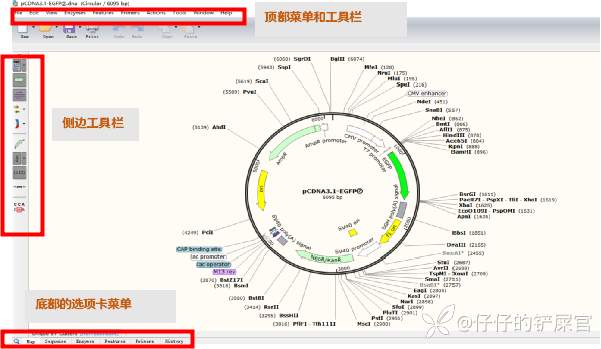
我们从上面网站获得目的基因序列后,一般会需要进行载体构建,最常用的即是Snagene软件。
顶部菜单栏分别是:
File:打开、建立、保存相关文件等;
Edit:编辑功能,包括复制选中一些序列等;
View: 切换几个视图等;
Enzymes:显示、选择酶切位点等;
Feature: 显示、注释(命名)一些片段等;Primers: 添加引物等;
Actions: 进行模拟PCR、无缝克隆等;
Tools:含有序列比对等工具;
Window: 窗口操作;
Help:提供帮助文件、版本号等信息。
Map视图下侧边工具栏:
从上到下依次为:
Show enzymes:可设置限制酶的筛选条件,从而找出unique酶;
Show features:显示片段的标注;
Show primers:显示引物;
Show translations:显示翻译后的序列;
Show colors:显示自定义序列颜色(默认序列为黑色);
Show features on the DNA line:改变feature的显示位置;
Show feature labels:是否显示feature的命名;
Show locations:是否显示酶切位点的位置;
Show horiziontal map:是否将质粒以线性方式显示;
Show alignments:显示序列比对。
底部选项卡为不同视图。